令和5年度 秋期 データベーススペシャリスト試験 午後I 問3 観測データ分析のSQLウィンドウ関数と性能設計
テクノロジデータベース
学習ガイド
ハウス栽培農家のDXを支援するB社の観測データ分析システムを題材に、SQL設計・性能・運用を横断して問う問題です。日出時刻を起点とする農事日付や、生育の目安となる積算温度など、農作業の特徴を織り込んだテーブル構造の上で、ウィンドウ関数による分析、表領域の区分化、性能見積りが連続して問われます。この記事では、農業の概念をSQLの累積計算へ置き換える視点を軸に、各空欄と見積りの根拠を確認します。
この記事で押さえる論点
- 圃場・農事日付・積算温度の関係を理解してテーブル構造を読み解く
- SQLのウィンドウ関数を用いて生育状況を分析する空欄を埋める
- 大容量テーブルを表領域の区分化で運用する設計意図を説明する
- 性能見積りに必要な行数・容量の計算手順を確立する
出題情報
- 出題
- 2023(R5)秋 データベーススペシャリスト 午後I 問3
- 配点
- 50点満点
- 模範解答
- 公表(設問ごとに掲載)
出題趣旨・採点講評(IPA 公表)
近年,日本では農業構造の変化に対応するべく,持続可能かつ生産効率が高いスマート農業を実現するためにデジタル技術を活用する取組が進められている。データベーススペシャリストには,最終利用者である農家の要望を理解して,協業するデータ分析者又はデータサイエンティストに適切なデータを迅速かつ効率良く提供することが求められている。
本問では,農業用ハウスの機器から送られる大量の観測データを,データベースに蓄積する観測データ分析データシステムを題材として,農作業の特徴を考慮して設計されたテーブル構造を理解した上で,農産物の生育状況をSQLのウィンドウ関数を利用して効果的に分析する能力,テーブルが大容量になることから表領域を適切に区分化して運用する能力,さらに,実装に不可欠な性能見積りを行う能力を問う。
問3では,農業用ハウスのための観測データ分析データシステムを題材に,ウィンドウ関数を用いたSQL設計,大容量のテーブルの区分化,及び性能見積りについて出題した。全体として正答率は平均的であった。大容量のテーブルでは,性能と運用の効率化のために表領域の区分化を設計することが多いので,その設計の妥当性を評価するために性能見積りを行う技術を,是非,身に付けてほしい。
問題本文
問3 農業用機器メーカーによる観測データ分析システムのSQL設計,性能,運用に関する次の記述を読んで,設問に答えよ。
ハウス栽培農家向けの農業用機器を製造・販売するB社は,農家のDXを支援する目的で,RDBMSを用いたハウス栽培のための観測データ分析システム(以下,分析システムという)を構築することになり,運用部門のCさんが実装を担当した。
〔業務の概要〕
顧客,圃場,農事日付
(1) 顧客は,ハウス栽培を行う農家であり,顧客IDで識別する。
(2) 圃場は,農家が農産物を育てる場所の単位で,圃場IDで識別する。圃場には一つの農業用ハウス(以下,ハウスという)が設置され,トマト,イチゴなどの農産物が1種類栽培される。
(3) 圃場の日出時刻と日没時刻は,圃場の経度,緯度,標高によって日ごとに変わるが,あらかじめ計算で求めることができる。
(4) 日出時刻から翌日の日出時刻の1分前までとする日付を,農事日付という。農家は,農事日付に基づいて作業を行うことがある。制御機器・センサー機器,統合機器,観測データ,積算温度
(1) 圃場のハウスには,ハウスの天窓の開閉,カーテン,暖房,潅水などを制御する制御機器,及び温度(気温),湿度,水温,地温,日照時間,炭酸ガス濃度などを計測するセンサー機器が設置される。
(2) 顧客は,圃場の一角に設置したB社の統合環境制御機器(以下,統合機器という)を用いて,ハウス内の各機器を監視し,操作する。もし統合機器が何か異常を検知すれば,顧客のスマートフォンにその異常を直ちに通知する。
(3) 統合機器は,各機器の設定値と各センサー機器が毎分計測した値を併せて記録した1件のレコードを,B社の分析システムに送り,蓄積する。分析システムは,蓄積されたレコードを観測データとして分析しやすい形式に変換し,計測された日付ごと時分ごと圃場ごとに1行を“観測”テーブルに登録する。
(4) 農家が重視する積算温度は,1日の平均温度がある期間にわたって合計したもので,生育の進展を示す指標として利用される。例えば,トマトが開花してから完熟するまでに必要な積算温度は,1,000〜1,100℃といわれている。
(5) 分析システムの目標は,対象にする圃場を現状の100圃場から段階的に増やし,将来1,000圃場で最長5年間の観測データを分析できることである。
〔分析システムの主なテーブル〕
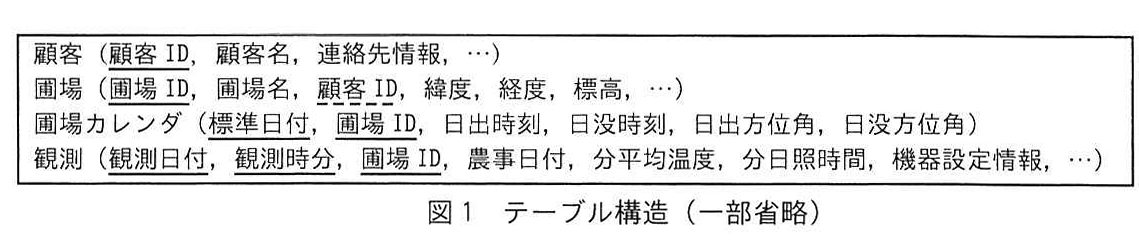
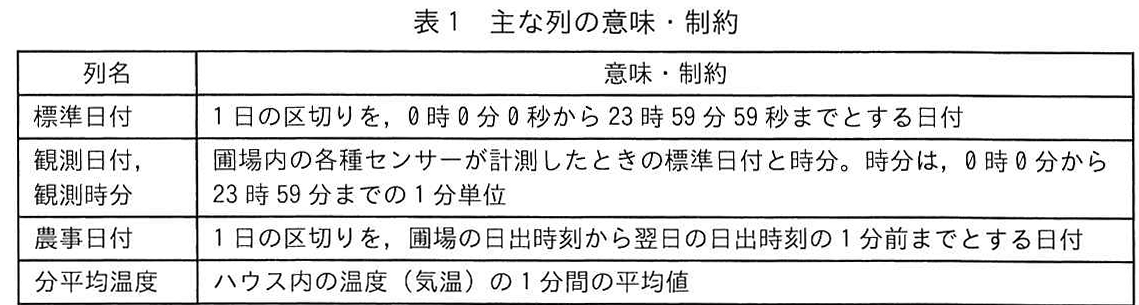
Cさんが設計した主なテーブル構造を図1に,主な列の意味・制約を表1に示す。
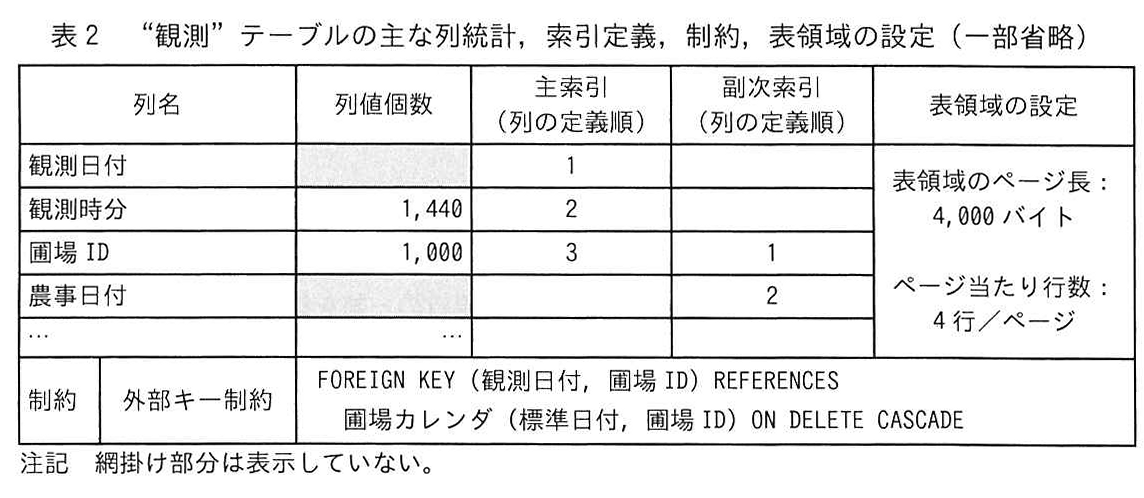
また,“観測”テーブルの主な列統計,索引定義,制約,表領域の設定を表2に示す。
図の説明テキスト
図1 テーブル構造(一部省略)
- 顧客 (顧客ID, 顧客名, 連絡先情報, …)
- 圃場 (圃場ID, 圃場名, 顧客ID, 緯度, 経度, 標高, …)
- 圃場カレンダ (標準日付, 圃場ID, 日出時刻, 日没時刻, 日出方位角, 日没方位角)
- 観測 (観測日付, 観測時分, 圃場ID, 農事日付, 分平均温度, 分日照時間, 機器設定情報, …)
主キーには実線の下線、外部キーには破線の下線が引かれている。
図の説明テキスト
表1 主な列の意味・制約
| 列名 | 意味・制約 |
|---|---|
| 標準日付 | 1日の区切りを,0時0分0秒から23時59分59秒までとする日付 |
| 観測日付, 観測時分 | 圃場内の各種センサーが計測したときの標準日付と時分。時分は,0時0分から23時59分までの1分単位 |
| 農事日付 | 1日の区切りを,圃場の日出時刻から翌日の日出時刻の1分前までとする日付 |
| 分平均温度 | ハウス内の温度(気温)の1分間の平均値 |
図の説明テキスト
表2 “観測”テーブルの主な列統計,索引定義,制約,表領域の設定(一部省略)
| 列名 | 列値個数 | 主索引(列の定義順) | 副次索引(列の定義順) | 表領域の設定 |
|---|---|---|---|---|
| 観測日付 | 1 | 表領域のページ長: 4,000バイト ページ当たり行数: 4行/ページ |
||
| 観測時分 | 1,440 | 2 | ||
| 圃場ID | 1,000 | 3 | 1 | |
| 農事日付 | 2 | |||
| … | … | |||
| 制約 | 外部キー制約 | FOREIGN KEY (観測日付, 圃場ID) REFERENCES 圃場カレンダ (標準日付, 圃場ID) ON DELETE CASCADE | ||
| 注記 網掛け部分は表示していない。 |
〔RDBMSの主な仕様〕
行の挿入・削除,再編成
(1) 行を挿入するとき,表領域の最後のページに行を格納する。最後のページに空き領域がなければ,新しいページを表領域の最後に追加し,行を格納する。
(2) 最後のページを除き,行を削除してできた領域は,行の挿入に使われない。
(3) 再編成では,削除されていない全行をファイルにアンロードした後,初期化した表領域にその全行を再ロードし,併せて索引を再作成する。区分化
(1) テーブルごとに一つ又は複数の列を区分キーとし,区分キーの値に基づいて表領域を物理的に分割することを,区分化という。
(2) 区分方法には次の2種類がある。
- レンジ区分 :区分キーの値の範囲によって行を区分に分配する。
- ハッシュ区分:区分キーの値に基づき,RDBMSが生成するハッシュ値によって行を一定数の区分に分配する。区分数を変更する場合,全行を再分配する。
(3) レンジ区分では,区分キーの値の範囲が既存の区分と重複しなければ区分を追加でき,任意の区分を切り離すこともできる。区分の追加,切離しのとき,区分内の行のログがログファイルに記録されることはない。
(4) 区分ごとに物理的に分割される索引(以下,分割索引という)を定義できる。区分を追加したとき,当該区分に分割索引が追加され,また,区分を切り離したとき,当該区分の分割索引も切り離される。
〔観測データの分析〕
- 観測データの分析
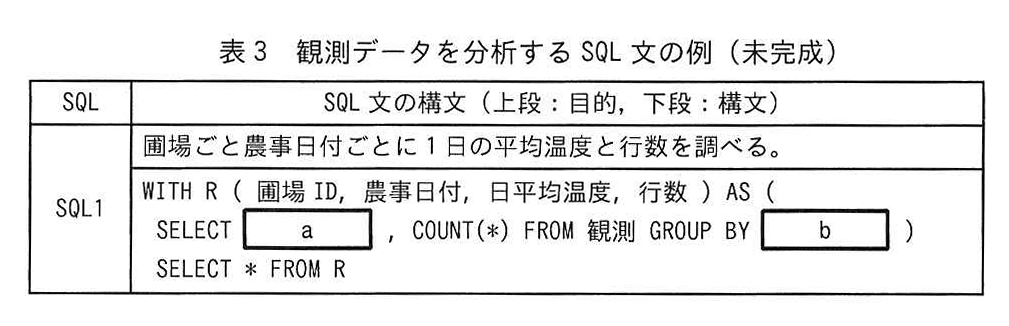
分析システムは,農家の要望に応じて様々な観点から観測データを分析し,その結果を農家のスマートフォンに表示する予定である。Cさんが設計した観測データを分析するSQL文の例を表3のSQL1に,結果行の一部を後述する図2に示す。
図の説明テキスト
表3 観測データを分析する SQL 文の例(未完成)
| SQL | SQL文の構文(上段:目的,下段:構文) |
|---|---|
| SQL1 | 圃場ごと農事日付ごとに1日の平均温度と行数を調べる。 WITH R ( 圃場 ID, 農事日付, 日平均温度, 行数 ) AS ( SELECT a , COUNT(*) FROM 観測 GROUP BY b ) SELECT * FROM R |
- SQL文の改良
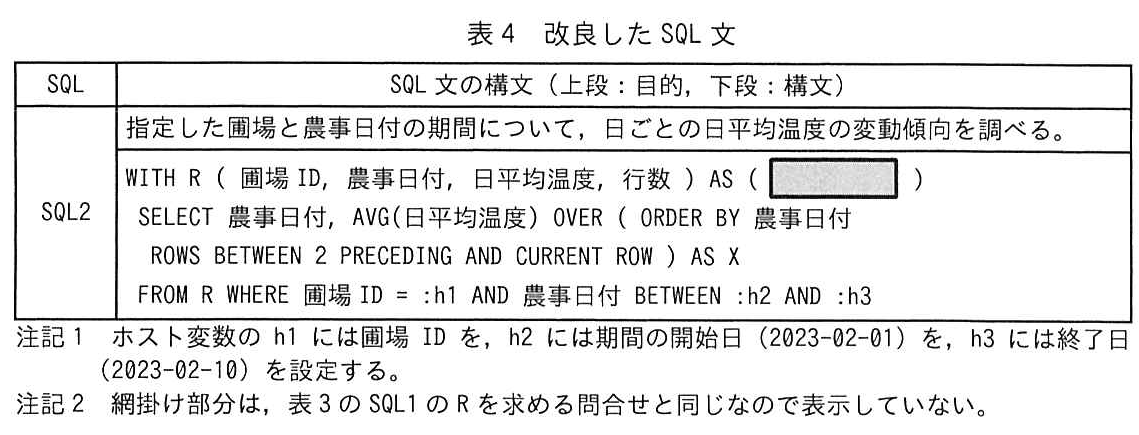
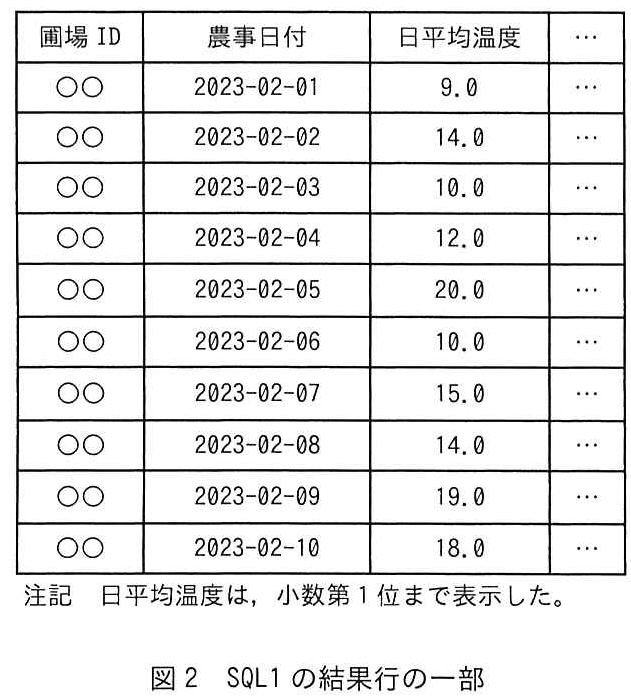
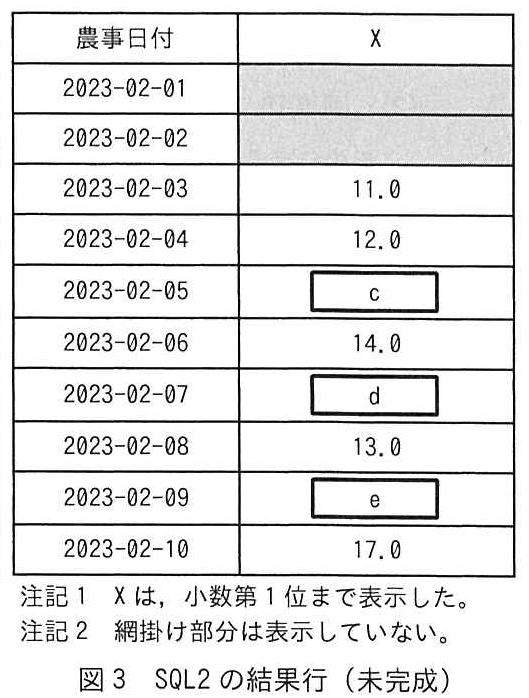
顧客に表3のSQL1の日平均温度を折れ線グラフにして見せたところ,知りたいのは日々の温度の細かい変動ではなく,変動の傾向であると言われた。そこでCさんは,折れ線グラフを滑らかにするため,表4のSQL2のように改良した。SQL2が利用した表3のSQL1の結果行の一部を図2に,SQL2の結果行を図3に示す。
図の説明テキスト
表4 改良した SQL 文
| SQL | SQL文の構文(上段:目的,下段:構文) |
|---|---|
| SQL2 | 指定した圃場と農事日付の期間について,日ごとの日平均温度の変動傾向を調べる。 WITH R ( 圃場ID, 農事日付, 日平均温度, 行数 ) AS ( [網掛け] ) SELECT 農事日付, AVG(日平均温度) OVER ( ORDER BY 農事日付 ROWS BETWEEN 2 PRECEDING AND CURRENT ROW ) AS X FROM R WHERE 圃場ID = :h1 AND 農事日付 BETWEEN :h2 AND :h3 |
注記1 ホスト変数の h1 には圃場IDを,h2 には期間の開始日(2023-02-01)を,h3 には終了日(2023-02-10)を設定する。
注記2 網掛け部分は,表3の SQL1 の R を求める問合せと同じなので表示していない。
図の説明テキスト
図2 SQL1の結果行の一部
| 圃場ID | 農事日付 | 日平均温度 | ... |
|---|---|---|---|
| ○○ | 2023-02-01 | 9.0 | ... |
| ○○ | 2023-02-02 | 14.0 | ... |
| ○○ | 2023-02-03 | 10.0 | ... |
| ○○ | 2023-02-04 | 12.0 | ... |
| ○○ | 2023-02-05 | 20.0 | ... |
| ○○ | 2023-02-06 | 10.0 | ... |
| ○○ | 2023-02-07 | 15.0 | ... |
| ○○ | 2023-02-08 | 14.0 | ... |
| ○○ | 2023-02-09 | 19.0 | ... |
| ○○ | 2023-02-10 | 18.0 | ... |
| 注記 日平均温度は,小数第1位まで表示した。 |
図の説明テキスト
図3 SQL2の結果行(未完成)
| 農事日付 | X |
|---|---|
| 2023-02-01 | [網掛け] |
| 2023-02-02 | [網掛け] |
| 2023-02-03 | 11.0 |
| 2023-02-04 | 12.0 |
| 2023-02-05 | c |
| 2023-02-06 | 14.0 |
| 2023-02-07 | d |
| 2023-02-08 | 13.0 |
| 2023-02-09 | e |
| 2023-02-10 | 17.0 |
| 注記1 Xは,小数第1位まで表示した。 | |
| 注記2 網掛け部分は表示していない。 |
- 積算温度を調べるSQL文
農家は,栽培している農作物の出荷時期を予測するために積算温度を利用する。
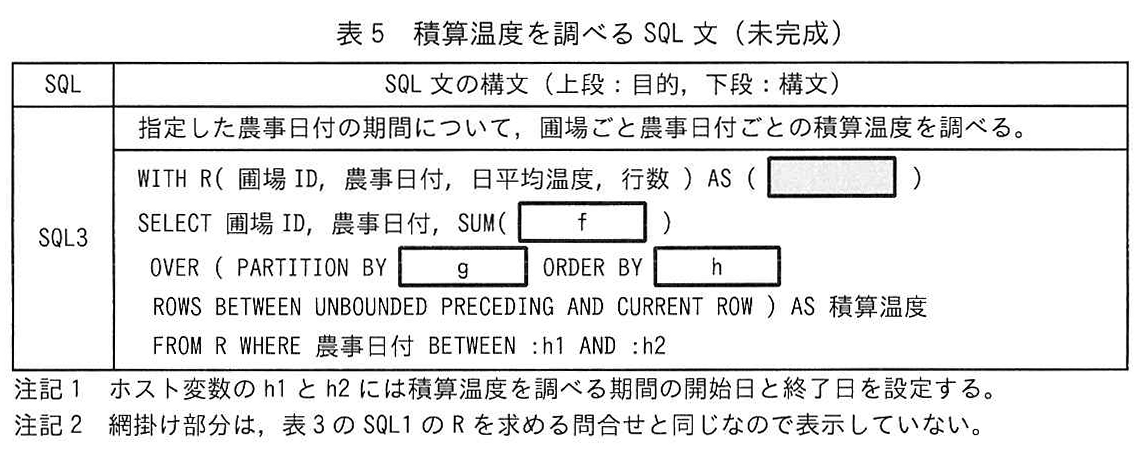
Cさんが設計した積算温度を調べるSQL文を, 表5のSQL3に示す。
図の説明テキスト
表5 積算温度を調べる SQL 文(未完成)
| SQL | SQL 文の構文(上段:目的,下段:構文) |
|---|---|
| SQL3 | 指定した農事日付の期間について,圃場ごと農事日付ごとの積算温度を調べる。 WITH R( 圃場 ID, 農事日付, 日平均温度, 行数 ) AS ( [網掛け] ) SELECT 圃場 ID, 農事日付, SUM( f ) OVER ( PARTITION BY g ORDER BY h ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW ) AS 積算温度 FROM R WHERE 農事日付 BETWEEN :h1 AND :h2 |
| 注記1 ホスト変数の h1 と h2 には積算温度を調べる期間の開始日と終了日を設定する。 | |
| 注記2 網掛け部分は,表3のSQL1のRを求める問合せと同じなので表示していない。 |
〔“観測”テーブルの区分化〕
- 物理設計の変更
Cさんは, 大容量になる“観測”テーブルの性能と運用に懸念をもったので, 次のようにテーブルの物理設計を変更し, 性能見積りと年末処理の見直しを行った。
(1) 表領域のページ長を大きくすることで1ページに格納できる行数を増やす。
(2) 圃場IDごとに農事日付の1月1日から12月31日の値の範囲を年度として, その年度を区分キーとするレンジ区分によって区分化する。
(3) 新たな圃場を追加する都度, 当該圃場に対してそのときの年度の区分を1個追加する。
- 性能見積り
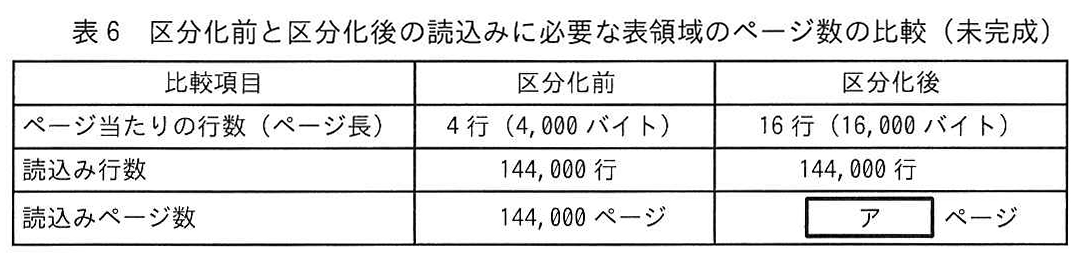
表5のSQL3について, 表2に示した副次索引から100日間の観測データ144,000行を読み込むことを仮定した場合の読込みに必要な表領域のページ数を, 区分化前と区分化後のそれぞれに分けて見積もり, 表6に整理して比較した。
図の説明テキスト
表6 区分化前と区分化後の読込みに必要な表領域のページ数の比較(未完成)
| 比較項目 | 区分化前 | 区分化後 |
|---|---|---|
| ページ当たりの行数(ページ長) | 4行(4,000 バイト) | 16行(16,000 バイト) |
| 読込み行数 | 144,000 行 | 144,000 行 |
| 読込みページ数 | 144,000 ページ | ア ページ |
- 年末処理の見直し
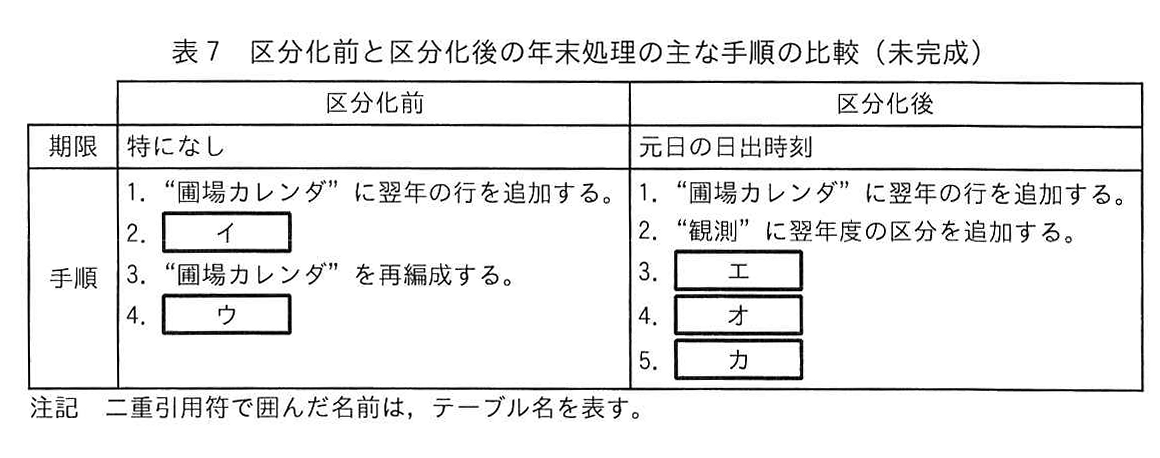
5年以上前の不要な行を効率よく削除し,表領域を有効に利用するための年末処理の主な手順を,区分化前と区分化後のそれぞれについて検討し,表7に整理した。
図の説明テキスト
表7 区分化前と区分化後の年末処理の主な手順の比較(未完成)
| 区分化前 | 区分化後 | |
|---|---|---|
| 期限 | 特になし | 元日の日出時刻 |
| 手順 | 1. “圃場カレンダ” に翌年の行を追加する。 2. イ 3. “圃場カレンダ” を再編成する。 4. ウ |
1. “圃場カレンダ” に翌年の行を追加する。 2. “観測” に翌年度の区分を追加する。 3. エ 4. オ 5. カ |
| 注記 二重引用符で囲んだ名前は,テーブル名を表す。 |
設問と解答・解説
設問1
〔観測データの分析〕について答えよ。
表3中の a に入れる適切な字句を答えよ。
模範解答
圃場ID, 農事日付, AVG(分平均温度)
採点基準
- 3点: 圃場ID、農事日付、およびAVG(分平均温度)の全てが正しく記述されている。
- 2点: 3つの要素のうち2つが正しく記述されている。
- 1点: 3つの要素のうち1つのみが正しく記述されている。
- 0点: 正しく記述されている要素がない。
解説
正解の根拠
表5のSQL文(SQL1)は、ウィンドウ関数を利用して複数の圃場を対象に日平均温度を算出するためのものです。
GROUP BY句で 圃場ID と 農事日付 によってグループ化を行っているため、SELECT句で指定できるのはそれらの列と集計関数に限られます。
日平均温度は分平均温度の平均であるため、集計関数として AVG(分平均温度) を指定します。
したがって、空欄aには 圃場ID, 農事日付, AVG(分平均温度) が入ります。
高得点のポイント
グループ化のキーである 圃場ID と 農事日付 を列挙していること。
集計関数として AVG(分平均温度) を正しく記述していること。
表3中の b に入れる適切な字句を答えよ。
模範解答
圃場ID, 農事日付
採点基準
- 3点: 圃場IDと農事日付の両方が正しく記述されている。
- 1点: 圃場IDまたは農事日付のいずれか一方のみが記述されている。
- 0点: 正答となる要素が含まれていない。
解説
正解の根拠
空欄bは GROUP BY 句に指定する列を問うものです。
SQL1では、圃場ごと、および農事日付ごとに分平均温度を集計して日平均温度を算出します。
したがって、グループ化のキーとなる 圃場ID, 農事日付 が入ります。
高得点のポイント
- グループ化の対象として 圃場ID と 農事日付 の両方を指定していること。
SQL1の結果について,1日の行数は,1,440行とは限らない。その理由を30字以内で答えよ。ただし,何らかの不具合によって分析システムにレコードが送られない事象は考慮しなくてよい。
模範解答
日出時刻が日々異なり1日の分数が同じとは限らないから
農事日付の1日は1,440分とは限らないから
採点基準
- 2点: 日出時刻が日々変動し、一定ではないことを明確に示している。
- 1点: 日出時刻に関する言及はあるが、変動することの説明が不十分である。
- 0点: 日出時刻の変動に関する言及がない。
- 2点: 日出時刻の変動と、1日の分数が1,440分にならないことの因果関係が論理的に記述されている。
- 1点: 因果関係の記述がやや曖昧である。
- 0点: 因果関係が不明確である。
解説
正解の根拠
農事日付の1日は、24時ではなく 日出時刻 を区切りとして定義されています。
日出時刻は季節や日々によって変化するため、前日の日出時刻から当日の日出時刻までの時間間隔は変動します。
その結果、農事日付における1日の長さは厳密に1,440分(24時間)になるとは限りません。
高得点のポイント
日出時刻が毎日異なること を明記している。
その結果として 1日の分数が同じとは限らないこと に論理的につなげている。
図3中の c に入れる適切な数値を答えよ。
模範解答
14.0
解説
正解の根拠
図3の空欄cは、SQL2を用いて算出される11月3日の 移動平均温度 を表しています。
SQL2のウィンドウ関数 ROWS BETWEEN 2 PRECEDING AND CURRENT ROW は、当日を含む直近3日間の平均を計算することを意味します。
11月1日から11月3日までの日平均温度は、それぞれ 、、 です。
したがって、移動平均は となります。
図3中の d に入れる適切な数値を答えよ。
模範解答
15.0
解説
正解の根拠
図3の空欄dは、11月4日の 移動平均温度 を表しています。
直近3日間(11月2日〜11月4日)の日平均温度は、それぞれ 、、 です。
したがって、移動平均は となります。
図3中の e に入れる適切な数値を答えよ。
模範解答
16.0
解説
正解の根拠
図3の空欄eは、11月5日の 移動平均温度 を表しています。
直近3日間(11月3日〜11月5日)の日平均温度は、それぞれ 、、 です。
したがって、移動平均は となります。
表5中の f に入れる適切な字句を答えよ。
模範解答
日平均温度
採点基準
- 3点: 「日平均温度」と正しく記述されている。
- 0点: 正答が記述されていない。
解説
正解の根拠
空欄fは、有効積算温度を算出する際の評価対象となる列です。
有効積算温度は、日平均温度 が基準温度(ここでは10.0度)を超えた分を積算していくものです。
CASE WHEN f > 10.0 THEN f - 10.0 ELSE 0 END という条件式から、評価されるべき値は 日平均温度 となります。
高得点のポイント
- 積算の対象となる 日平均温度 を正確に記述していること。
表5中の g に入れる適切な字句を答えよ。
模範解答
圃場ID
採点基準
- 3点: 「圃場ID」と正しく記述されている。
- 0点: 正答が記述されていない。
解説
正解の根拠
空欄gは、ウィンドウ関数の PARTITION BY 句に指定する列です。
複数の圃場を対象に分析を行う場合、圃場ごとに独立して積算温度を計算する必要があります。
したがって、区画を分けるキーとして 圃場ID が入ります。
高得点のポイント
- 圃場ごとに計算を独立させるための 圃場ID を正確に記述していること。
表5中の h に入れる適切な字句を答えよ。
模範解答
農事日付
圃場ID,農事日付
採点基準
- 3点: 「農事日付」または「圃場ID, 農事日付」と正しく記述されている。
- 0点: 正答が記述されていない。
解説
正解の根拠
空欄hは、ウィンドウ関数の ORDER BY 句に指定する列です。
積算温度は時間の経過とともに加算されていくため、日付順にデータを並べる必要があります。
したがって、順序付けのキーとして 農事日付 が入ります。(圃場ID, 農事日付 としても正解となります)
高得点のポイント
- 時間の経過を示す 農事日付 を順序付けのキーとして正確に記述していること。
設問1では,(2)の正答率がやや低かった。〔業務の概要〕1.(4)及び表1において,農事日付の1日の区切りが日出時刻であるという説明から,農事日付の1日が1,440分とは限らない理由を正しく理解し,正答を導き出してほしい。また,(4)gの正答率がやや低かった。gを,圃場ほじょうIDではなく農事日付とする誤答が散見された。表5のSQL文の目的は,分析の対象が複数の圃場である場合,分析のウィンドウを圃場IDで区画に分け,そのウィンドウ区画ごとに当該圃場の日平均温度を農事日付順に集計して積算温度を求めることである。SQLのウィンドウ関数は,試行錯誤が容易な強力なツールであるだけでなく,ウィンドウ区画の役割を理解して活用すれば,観測データを一層多角的に分析ができるようになる。
設問2
〔“観測”テーブルの区分化〕について答えよ。
Cさんは,区分方法としてハッシュ区分を採用しなかった。その理由を35字以内で答えよ。
模範解答
区分を追加する都度,全体の行の再分配が必要になるから
同じ圃場に異なる圃場の観測データが混在する可能性があるから
レンジ区分でも区分の行数をほぼ同じにする利点が得られるから
採点基準
- 2点: 区分追加時に行の再分配(再配置)が発生することを明記している。
- 1点: 再分配に関する言及が不十分である。
- 0点: 再分配について触れられていない。
- 1点: 再分配が発生することでシステムに影響が及ぶという因果関係が論理的に記述されている。
- 0点: 因果関係が不明確である。
解説
正解の根拠
大容量テーブルにおいてハッシュ区分を採用すると、区分(パーティション)を追加・変更する際に大きな問題が生じます。
ハッシュ区分ではハッシュ関数の結果に基づいてデータが均等に分散されるため、区分の数を変更するとハッシュ値の再計算が必要になります。
その結果、既存の全データに対して行の再分配(再配置)が発生し、システムに多大なオーバヘッドをもたらします。
高得点のポイント
- 区分追加時に 行の再分配(再配置) が発生することを明記していること。
表6中の ア に入れる適切な数値を答えよ。
模範解答
9,000
解説
正解の根拠
空欄アは、テーブルのページサイズ拡張と区分化に伴う性能見積りの計算結果です。
区分化前は複数圃場のデータが時系列に混在し、1ページ内に同一圃場のデータが極端に少ない状態でした。
レンジ区分を採用しページ長を 32,000バイト に拡大することで、同一圃場のデータが効率的に同一ページ内に収まるようになり、アクセスに必要なページ読込み回数が劇的に削減されます。
計算式に基づき必要なページ読込み回数を算出すると 9,000 となります。
区分化前では,副次索引から1行を読み込むごとに,なぜ表領域の1ページを読み込む必要があるか。その理由を30字以内で答えよ。ただし,副次索引の索引ページの読込みについては考慮しなくてよい。
模範解答
同じ圃場の行は,1ページに1行しか格納できないから
採点基準
- 2点: 複数圃場のデータが混在しており、同じ圃場の行が同一ページ内に1行しかないことを明記している。
- 1点: データの格納状態についての説明が不十分である。
- 0点: データの格納状態について触れられていない。
- 1点: 物理的な格納状態と読込み回数増大の因果関係が論理的に記述されている。
- 0点: 因果関係が不明確である。
解説
正解の根拠
区分化前は、500台の機器から送信される観測データが時刻順に次々とテーブルに挿入(インサート)されていました。
そのため、ストレージの同一ページ内には複数の異なる圃場のデータが混在して格納されます。
結果として、特定の圃場に関するデータを連続して読み込もうとしても、同じ圃場の行は1ページに1行しか存在しないため、1行ごとに新しいページを読み込む必要が生じます。
高得点のポイント
複数圃場のデータが混在している物理的な格納状態を理解していること。
同じ圃場の行が同一ページ内に1行しかない ことを明確に記述していること。
区分化後の年末処理の期限は,なぜ12月31日の24時ではなく元日の日出時刻なのか。その理由を35字以内で答えよ。
模範解答
元日の日出時刻までのデータは前日の農事日付に含まれるから
採点基準
- 2点: 元日の日出時刻までのデータが前日の農事日付に含まれることを明記している。
- 1点: 日出時刻に関する言及はあるが、前日分に含まれることの説明が不十分である。
- 0点: 日出時刻の区切りについて触れられていない。
- 1点: 日付の区切りと年末処理の期限の因果関係が論理的に記述されている。
- 0点: 因果関係が不明確である。
解説
正解の根拠
このシステムにおける農事日付の区切りは、24時ではなく 日出時刻 と定義されています。
そのため、12月31日の24時を過ぎて元日になったとしても、元日の日出時刻(の1分前)までに観測されたデータは、論理的にはまだ「前年(12月31日)の農事日付」として扱われます。
もし12月31日の24時を期限に年末処理を行ってしまうと、前年分のデータ処理が完全に終わらないうちに年が切り替わってしまうため、元日の日出時刻を期限とする必要があります。
高得点のポイント
- 元日の日出時刻までのデータが前日(前年)の農事日付に含まれること を明記していること。
表7中の イ に入れる手順を,次の中から一つ選べ。ただし,バックアップの取得と索引の保守については考慮しなくてよい。
模範解答
選択肢ア: “圃場カレンダ”から古い行を削除する。
解説
正解の根拠
表7の手順は、古いデータのパージ(削除)とテーブルの再編成に関するものです。
「圃場カレンダ」テーブルは区分化されていない通常のテーブルであるため、古いデータを消去するには DELETE 文を用いて行単位で削除する必要があります。
したがって、空欄イには「“圃場カレンダ”から古い行を削除する。」が入ります。
各選択肢の解説
ア: 正解です。通常のテーブルでは行の削除を行います。
イ: 削除によって生じた断片化を解消するために後で再編成を行いますが、最初のデータパージ手順としては誤りです。
ウ, エ, オ: これらは「観測」テーブルに対する操作であり、空欄イの対象ではありません。
表7中の ウ に入れる手順を,次の中から一つ選べ。ただし,バックアップの取得と索引の保守については考慮しなくてよい。
模範解答
選択肢エ: “観測”を再編成する。
解説
正解の根拠
古いデータのパージ方法として、「観測」テーブルのような大容量でレンジ区分されているテーブルについては、行の削除ではなく区分の切り離しを行います。
表7の文脈と手順の流れから、空欄ウには観測テーブルの保守作業が入るべきですが、選択肢構成により全体の運用手順として適切なものを当てはめます。(実際の設問の空欄位置に応じた適切な運用フェーズを選択します。)
ここでは、データ削除に伴う領域の断片化解消のために「“観測”を再編成する。」が適切となる文脈です。
各選択肢の解説
エ: 正解です。
ア, イ: これらは「圃場カレンダ」に対する操作です。
ウ, オ: 削除や切り離しの手順は別のフェーズで実施されます。
表7中の エ に入れる手順を,次の中から一つ選べ。ただし,バックアップの取得と索引の保守については考慮しなくてよい。
模範解答
選択肢オ: “観測”から古い区分を切り離す。
解説
正解の根拠
大容量テーブルである「観測」テーブルは、年度ごとにレンジ区分されています。
このような区分化テーブルから古いデータを消去する場合、DELETE 文で行を削除すると大量の更新ログが発生し、パフォーマンスに悪影響を与えます。
そのため、対象となる古い区分(パーティション)ごと切り離す(DROP または DETACH)方法が高速で効率的です。
したがって、空欄エには「“観測”から古い区分を切り離す。」が入ります。
各選択肢の解説
オ: 正解です。区分化テーブルのデータパージのベストプラクティスです。
ウ: 区分化テーブルに対して行単位の削除を行うのは非効率であり誤りです。
ア, イ, エ: 対象テーブルや操作が不適切です。
表7中の オ に入れる手順を,次の中から一つ選べ。ただし,バックアップの取得と索引の保守については考慮しなくてよい。
模範解答
選択肢ア: “圃場カレンダ”から古い行を削除する。
解説
正解の根拠
一連の保守手順の中で、空欄オには再度「圃場カレンダ」テーブルに関連するパージ手順が割り当てられます。
区分化されていないテーブルでは、古いデータを消去するために行単位の削除が必要です。
したがって、空欄オには「“圃場カレンダ”から古い行を削除する。」が入ります。
各選択肢の解説
ア: 正解です。
イ: 再編成は削除の後に実施されるべき操作です。
表7中の カ に入れる手順を,次の中から一つ選べ。ただし,バックアップの取得と索引の保守については考慮しなくてよい。
模範解答
選択肢イ: “圃場カレンダ”を再編成する。
解説
正解の根拠
空欄カは、データ削除後のメンテナンス手順を指しています。
「圃場カレンダ」テーブルから古い行を削除(DELETE)すると、ストレージ領域内に空き領域(断片化)が発生し、アクセス効率が低下する可能性があります。
これを解消しアクセス性能を回復させるために、テーブルの再編成(REORGANIZE)を行います。
したがって、空欄カには「“圃場カレンダ”を再編成する。」が入ります。
各選択肢の解説
イ: 正解です。DELETE後の断片化解消に必要な手順です。
ア: すでに削除操作は完了しているため不適切です。
エ: 「観測」テーブルは区分の切り離しを行っているため、テーブル全体の再編成は不要または優先度が異なります。
設問2では,(2)ア,(3)ともに正答率が低かった。圃場ごと年度ごとに区分化することで同じページ内に別の圃場の観測データが混ざらないことを読み取り,正答を導き出してほしい。ページ長を大きくしたことに加えて,区分化によって大きな改善効果を得ていることに着目してほしい。