令和3年度 秋期 データベーススペシャリスト試験 午後Ⅰ 問2 カード決済システムの性能見積りとテーブル区分化による改善
テクノロジデータベース
学習ガイド
クレジットカード会社のC社で、オーソリ処理の量が増えることによる性能低下の対策を検討する問題です。利用明細抽出処理の処理時間の見積り、データバッファや索引を追加する案の評価、オーソリ履歴テーブルの区分化の効果、更新処理を多重化したときにログがボトルネックになる理由が問われます。RDBMSの仕様に書かれた計算式と前提を、SQL文とテーブルの容量見積りに当てはめて考えます。
この記事で押さえる論点
- CPU時間とデータ入出力処理時間からSQLの処理時間を見積もる手順を説明できる
- アクセス経路(表探索、索引探索)の違いが、バッファヒット率向上による性能改善にどう影響するかを述べられる
- ハッシュ分割とレンジ分割の違いを理解し、要件に応じた適切な区分キーを選択できる
- 更新処理の多重化において、ログ出力処理がボトルネックとなる仕組みを説明できる
出題情報
- 出題
- 2021(R3)秋 データベーススペシャリスト 午後I 問2
- 配点
- 50点満点
- 模範解答
- 公表(設問ごとに掲載)
出題趣旨・採点講評(IPA 公表)
近年,ITシステムは重要な社会インフラとなり,高い負荷の下でも安定して稼働し続けることが期待されている。このような高負荷環境におけるデータベース設計では,RDBMSの機能を深く理解し,適切に使用して,性能要件を満たす設計を行う必要がある。本問では,クレジットカード会社におけるオーソリ業務を題材として,処理時間の見積り,バッファプールのチューニング,区分表の設計,ロギングの性能に関する考慮点を理解しているかを問う。
問2では,クレジットカードにおけるオーソリ業務を題材に,処理時間の見積り,バッファプールのチューニング,区分表の設計,ロギングの性能に関する考慮点について出題した。全体として正答率は低かった。
問題本文
データベースの実装に関する次の記述を読んで,設問1〜3に答えよ。
クレジットカード会社のC社では,キャッシュレス決済の普及に伴いカード決済システムのオンライントランザクションの処理量が増えている。情報システム部のFさんは,将来の処理量から懸念される性能低下の対策を検討することになった。
〔RDBMSの主な仕様〕
- アクセス経路,区分化,再編成
(1) アクセス経路は,RDBMSによって表探索又は索引探索に決められる。表探索では,索引を使わずに先頭ページから順に全行を探索する。索引探索では,WHERE句中の述語に適した索引によって絞り込んでから表の行を読み込む。
(2) テーブルごとに一つ又は複数の列を区分キーとし,区分キーの値に基づいて物理的な表領域に分割することを区分化という。
(3) 区分方法にはハッシュとレンジの二つがある。どちらも,テーブルを検索するSQL文のWHERE句の述語に区分キー列を指定すると,区分キー列で特定した区分だけを探索する。
- ① ハッシュは,区分キー値を基にRDBMSが生成するハッシュ値によって一定数の区分に行を分配する方法である。
- ② レンジは,区分キー値の範囲によって区分に行を分配する方法である。
(4) テーブル又は区分を再編成することによって,行を主キー順に物理的に並び替えることができる。また,各ページ中に指定した空き領域を予約することができる。
(5) INSERT文で行を挿入するとき,RDBMSは,主キー値の並びの中で,挿入行の主キー値に近い行が格納されているページに空き領域があればそのページに,なければ表領域の最後のページに格納する。最後のページに空き領域がなければ,新しいページを表領域の最後に追加する。
- データ入出力とログ出力
(1) データとログはそれぞれ別のディスクに格納される。同じディスクに対し同時に入出力は行われないものとする。
(2) データ入出力とログ出力は4,000 バイトのページ単位に行われる。
(3) データバッファはテーブルごとに確保される。
(4) ページをランダムに入出力する場合,SQL処理中のCPU処理と入出力処理は並行して行われない。これを同期データ入出力処理と呼び,SQL処理時間は次の式で近似できる。
(5) ページを順次に入出力する場合,SQL処理中のCPU処理と入出力処理は並行して行われる。これを非同期データ入出力処理と呼び,SQL処理時間は次の式で近似できる。ここで関数MAXは引数のうち最も大きい値を返す。
(6) 行を挿入,更新,削除した場合,変更内容がログとしてRDBMSに一つ存在するログバッファに書き込まれる。ログバッファが一杯の場合,トランザクションのINSERT文,UPDATE文,DELETE文の処理は待たされる。
(7) ログは,データより先にログバッファからディスクに出力される。これをログ出力処理と呼ぶ。このとき,トランザクションのコミットはログ出力処理の完了まで待たされる。ログ出力処理は,次のいずれかの事象を契機に行われる。
- ① ログバッファが一杯になった。
- ② トランザクションがコミット又はロールバックを行った。
- ③ あるテーブルのデータバッファが変更ページによって一杯になった。
〔カード決済システムの概要〕
- テーブル
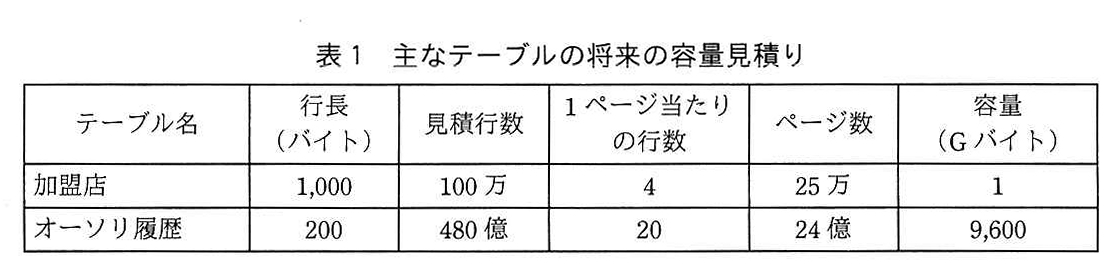
主なテーブルのテーブル構造を図1,将来の容量見積りを表1に示す。各テーブルの主キーには索引が定義されており,索引キーを構成する列の順はテーブルの列の順と同じである。
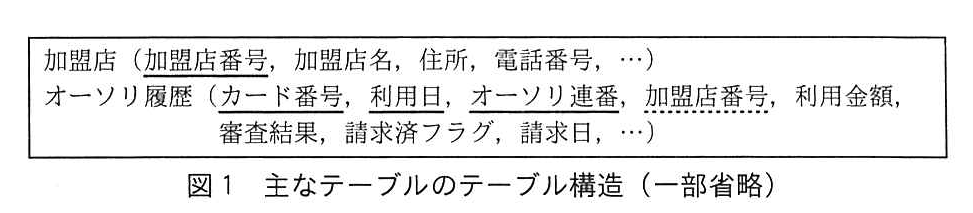
図の説明テキスト
主なテーブルのテーブル構造を示す図。原図では主キーを構成する列名に実線の下線、外部キーを構成する列名に破線の下線が付いており、ここではそれぞれ「(主キー)」「(外部キー)」と記す。
加盟店(加盟店番号(主キー),加盟店名,住所,電話番号,…)
オーソリ履歴(カード番号(主キー),利用日(主キー),オーソリ連番(主キー),加盟店番号(外部キー),利用金額,審査結果,請求済フラグ,請求日,…)
図の説明テキスト
主なテーブルの将来の容量見積りを示す表。
| テーブル名 | 行長(バイト) | 見積行数 | 1ページ当たりの行数 | ページ数 | 容量(Gバイト) |
|---|---|---|---|---|---|
| 加盟店 | 1,000 | 100万 | 4 | 25万 | 1 |
| オーソリ履歴 | 200 | 480億 | 20 | 24億 | 9,600 |
- オーソリ処理(オンライン処理)
オーソリ処理は,会員がカードで支払う際にカード有効期限,与信限度額を超過していないかなどを判定する処理である。判定した結果,可ならば審査結果を‘Y’に,否ならば‘N’に設定した行を“オーソリ履歴”テーブルに挿入する。オーソリ処理は最大100多重で処理される。“オーソリ履歴”テーブルには直近5年分を保持する。
- 利用明細抽出処理(バッチ処理)
請求書作成に必要な1か月分の利用明細の記録を“オーソリ履歴”テーブルから抽出しファイルに出力する。
〔参照処理の性能見積り〕
将来の処理時間が懸念される利用明細抽出処理のSQL文を,図2に示す。
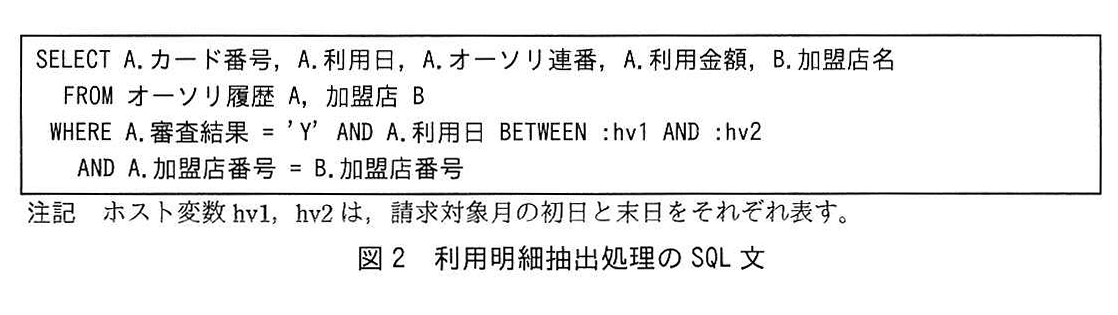
図の説明テキスト
利用明細抽出処理の SQL 文。
SELECT A.カード番号, A.利用日, A.オーソリ連番, A.利用金額, B.加盟店名
  FROM オーソリ履歴 A, 加盟店 B
 WHERE A.審査結果 = 'Y' AND A.利用日 BETWEEN :hv1 AND :hv2
   AND A.加盟店番号 = B.加盟店番号
注記 ホスト変数 hv1, hv2 は, 請求対象月の初日と末日をそれぞれ表す。
Fさんは,利用明細抽出処理の処理時間を,次のように見積もった。
- このSQL文での表の結合方法を調べたところ,“オーソリ履歴”テーブルを外側,“加盟店”テーブルを内側とする入れ子ループ法だった。“オーソリ履歴”テーブルのアクセス経路は表探索だったので,aページを非同期に読み込む。
- ディスク転送速度を100Mバイト/秒と仮定すれば,aページを非同期に読み込むデータ入出力処理時間は,b秒である。
- カード数を 1,000 万枚,カード・月当たり平均オーソリ回数を 80 回,審査結果が全て可であると仮定すると,“オーソリ履歴”テーブルの結果行数は,c 行である。これに掛かる CPU時間は,96,000 秒である。
- この結合では,外側の表の結果行ごとに“加盟店”テーブルの主キー索引を索引探索し,“加盟店”テーブルを 1 行,ランダムに合計 d 回読み込む。
- 索引はバッファヒット率 100%,テーブルはバッファヒット率 0%と仮定すれば,“加盟店”テーブルを合計で e ページを同期的に読み込むことになる。同期読込みにページ当たり 1 ミリ秒掛かると仮定すれば,同期データ入出力処理時間は f 秒である。
- 内側の表の索引探索と結合に掛かる CPU時間は,1 結果行当たり 0.01 ミリ秒掛かると仮定すれば, g 秒である。
- 外側の表の CPU時間は 96,000 秒,内側の表の CPU時間は g 秒,内側の表の同期データ入出力処理時間は f 秒なので,SQL文の処理時間を h 秒と見積もった。
処理時間が長くなることが分かったので時間短縮のため,次の 2 案を検討した。
- 案 1: “加盟店”テーブルのデータバッファを増やしバッファヒット率 100%にする。
- 案 2: “オーソリ履歴”テーブルの利用日列をキーとする副次索引を追加する。
〔“オーソリ履歴”テーブルの区分化〕
Fさんは,上司である G氏から,次の課題の解決策の検討を依頼された。
- 課題 1: 月末近くに起きるオーソリ処理の INSERT文の性能低下を改善すること
- 課題 2: 将来懸念される利用明細抽出処理の処理時間を短縮すること
- 課題 3: 月初に行う“オーソリ履歴”テーブル再編成の処理時間を短縮すること
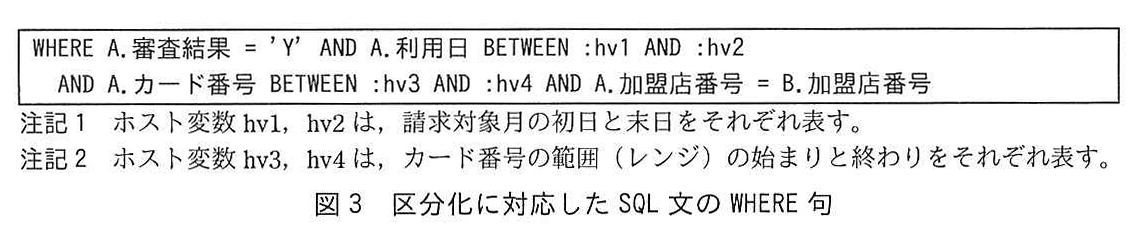
Fさんは,課題を解決するために,“オーソリ履歴”テーブルを区分化することにし,区分キーについて表 2 に示す 3 案を評価した。いずれの案も 60 区分に行を均等に分配する前提であり,図 2 の SQL文を基に区分化に対応した SQL文を作成した。作成した SQL文の WHERE句を図 3 に示す。利用明細抽出処理及び再編成について,アクセスする総ページ数が最小になるようにジョブを設計した。このときジョブは,必要に応じて並列実行させる。
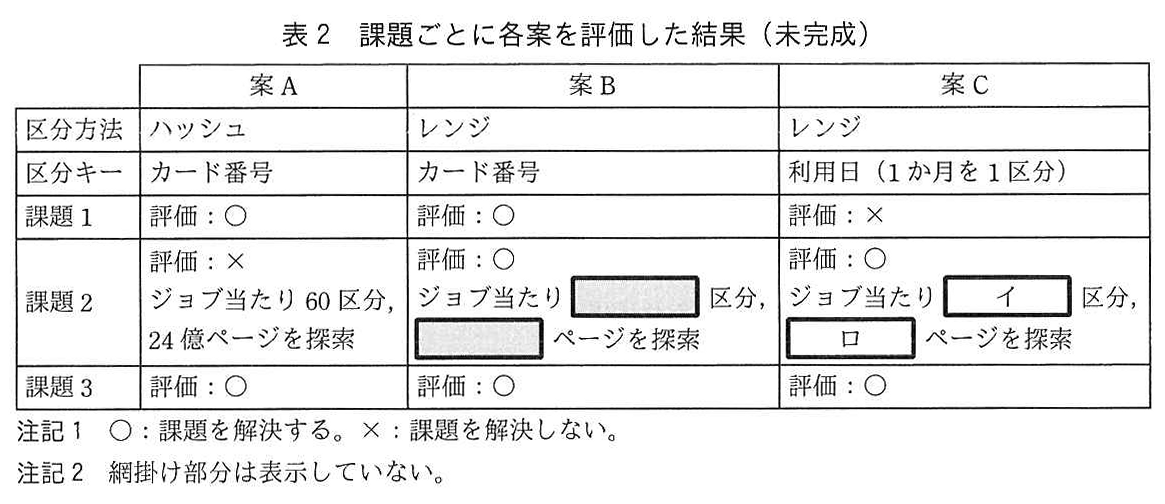
図の説明テキスト
表2 課題ごとに各案を評価した結果(未完成)
| 案 A | 案 B | 案 C | |
|---|---|---|---|
| 区分方法 | ハッシュ | レンジ | レンジ |
| 区分キー | カード番号 | カード番号 | 利用日(1か月を1区分) |
| 課題 1 | 評価:○ | 評価:○ | 評価:× |
| 課題 2 | 評価:× ジョブ当たり 60 区分, 24 億ページを探索 |
評価:○ ジョブ当たり (網掛け) 区分, (網掛け) ページを探索 |
評価:○ ジョブ当たり イ 区分, ロ ページを探索 |
| 課題 3 | 評価:○ | 評価:○ | 評価:○ |
注記1 ○:課題を解決する。×:課題を解決しない。
注記2 網掛け部分は表示していない。
図の説明テキスト
図3 区分化に対応した SQL 文の WHERE 句
WHERE A.審査結果 = 'Y' AND A.利用日 BETWEEN :hv1 AND :hv2
  AND A.カード番号 BETWEEN :hv3 AND :hv4 AND A.加盟店番号 = B.加盟店番号
注記1 ホスト変数 hv1, hv2 は, 請求対象月の初日と末日をそれぞれ表す。
注記2 ホスト変数 hv3, hv4 は, カード番号の範囲 (レンジ) の始まりと終わりをそれぞれ表す。
〔更新処理の多重化〕
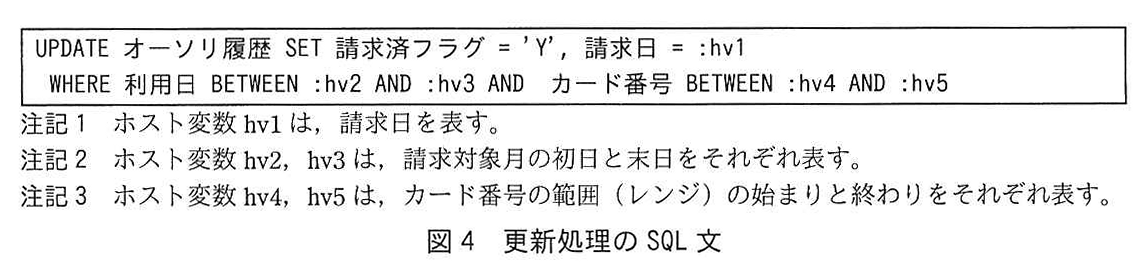
“オーソリ履歴”テーブルの請求済フラグと請求日を更新する処理も同様に,将来の処理時間が懸念された。更新処理のSQL文を図4に示す。更新処理はバッチ処理であり,カーソルを使用して 1,000行を更新するごとにコミットする。
図の説明テキスト
図4 更新処理の SQL 文
UPDATE オーソリ履歴 SET 請求済フラグ = 'Y', 請求日 = :hv1
  WHERE 利用日 BETWEEN :hv2 AND :hv3 AND カード番号 BETWEEN :hv4 AND :hv5
注記1 ホスト変数 hv1 は, 請求日を表す。
注記2 ホスト変数 hv2, hv3 は, 請求対象月の初日と末日をそれぞれ表す。
注記3 ホスト変数 hv4, hv5 は, カード番号の範囲 (レンジ) の始まりと終わりをそれぞれ表す。
Fさんは,次のように,区分化と併せて,更新処理を多重化することにした。
- “オーソリ履歴”テーブルについて,カード番号,利用日の順の組で区分キーとし,レンジによって区分化する。
- 区分ごとのジョブで更新処理を多重化する。
- 更新処理を多重化しても競合しないように,各区分を異なるディスクに配置し,データバッファを十分に確保する。
設問と解答・解説
設問1
〔参照処理の性能見積り〕について,(1)〜(3)に答えよ。
本文中の a に入れる適切な数値を答えよ。
模範解答
2,400,000,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕および表1「主なテーブルの将来の容量見積り」に基づいて計算します。
「オーソリ履歴」テーブルのアクセス経路は表探索です。表探索では、索引を使わずに先頭ページから順に全行を探索するため、全ページを読み込むことになります。
表1より、「オーソリ履歴」テーブルのページ数は 24億(2,400,000,000) ページです。
したがって、2,400,000,000ページを非同期に読み込むことになります。
本文中の b に入れる適切な数値を答えよ。
模範解答
96,000
解説
【問題の本文・図表】〔RDBMSの主な仕様〕2 (2) および〔参照処理の性能見積り〕の条件に基づいて計算します。
データ入出力は4,000バイトのページ単位で行われます。a(2,400,000,000ページ)を非同期に読み込む場合の総データ量は以下の通りです。
バイト
これをM(メガ)バイトに換算します。()
Mバイト
ディスク転送速度は100Mバイト/秒と仮定されているため、データ入出力処理時間は以下のようになります。
秒
したがって、データ入出力処理時間は 96,000 秒です。
本文中の c に入れる適切な数値を答えよ。
模範解答
800,000,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕の条件3と図2のSQL文に基づいて計算します。
図2のSQL文のWHERE句には A.審査結果 = 'Y' と A.利用日 BETWEEN :hv1 AND :hv2(1か月間)が指定されており、これにより抽出される行数が「結果行数」となります。
仮定として、カード数を1,000万枚、カード・月当たり平均オーソリ回数を80回、審査結果が全て可('Y')であるとしています。
したがって、1か月間の「オーソリ履歴」テーブルの抽出結果行数は以下のようになります。
行
したがって、結果行数は 800,000,000 行です。
本文中の d に入れる適切な数値を答えよ。
模範解答
800,000,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕の条件4に基づいて計算します。
このSQL文は「オーソリ履歴」テーブルを外側、「加盟店」テーブルを内側とする入れ子ループ法で結合されます。
入れ子ループ法では、外側の表の結果行1行ごとに、内側の表を1回探索して読み込みます。
外側の表(オーソリ履歴)の結果行数は、c で求めた 800,000,000 行です。
したがって、内側の「加盟店」テーブルをランダムに合計 800,000,000 回読み込むことになります。
本文中の e に入れる適切な数値を答えよ。
模範解答
800,000,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕の条件4と5に基づいて計算します。
「加盟店」テーブルへの読み込み回数は合計 800,000,000 回(dの答え)です。
条件5において、「索引はバッファヒット率100%、テーブルはバッファヒット率0%」と仮定されています。これは、索引探索による物理的なI/Oは発生しないが、テーブル行の実データを読み込む際には毎回物理的なI/O(同期読込み)が発生することを意味します。
1回の読み込みにつき「加盟店」テーブルのページを1ページ同期的に読み込むことになるため、読み込み回数と等しい 800,000,000 ページを同期的に読み込むことになります。
本文中の f に入れる適切な数値を答えよ。
模範解答
800,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕の条件5に基づいて計算します。
「加盟店」テーブルの同期読込みページ数は 800,000,000 ページ(eの答え)です。
同期読込みには1ページ当たり1ミリ秒( 秒)掛かると仮定されています。
したがって、同期データ入出力処理時間は以下のようになります。
秒
したがって、同期データ入出力処理時間は 800,000 秒です。
本文中の g に入れる適切な数値を答えよ。
模範解答
8,000
解説
【問題の本文・図表】〔参照処理の性能見積り〕の条件6に基づいて計算します。
内側の表(加盟店テーブル)の索引探索と結合は、外側の表の結果行1行ごとに実行されるため、合計実行回数は結果行数と同じ 800,000,000 回(cの答え)です。
1結果行当たり0.01ミリ秒( 秒)のCPU時間が掛かると仮定されています。
したがって、内側の表のCPU時間は以下のようになります。
秒
したがって、CPU時間は 8,000 秒です。
本文中の h に入れる適切な数値を答えよ。
模範解答
904,000
解説
【問題の本文・図表】〔RDBMSの主な仕様〕2 (4)(5) および〔参照処理の性能見積り〕の条件7に基づいてSQL全体の処理時間を計算します。
外側の表(オーソリ履歴)の処理時間:
表探索による順次アクセス(非同期データ入出力処理)です。
SQL処理時間
秒、非同期データ入出力処理時間 秒(bの答え)より、
秒となります。内側の表(加盟店)の処理時間:
索引探索によるランダムアクセス(同期データ入出力処理)です。
SQL処理時間
秒(gの答え)、同期データ入出力処理時間 秒(fの答え)より、
秒となります。
SQL文全体の処理時間は、これらを合計したものになります。
秒
したがって、処理時間は 904,000 秒です。
案1について,“加盟店”テーブルのデータバッファを増やすのはなぜか。アクセス経路に着目し,理由を25字以内で述べよ。
模範解答
ランダムアクセスの処理時間を短縮できるから
採点基準
- 2点: 加盟店テーブルへのアクセスがランダムアクセスであることを理解し、その処理時間短縮に言及している。
- 1点: 加盟店テーブルへのアクセス時間を短縮できることは記載しているが、ランダムアクセスであることの言及が不明確。
- 0点: 上記の内容が含まれていない。
- 1点: データバッファを増やすことと、アクセス時間の短縮が論理的につながっている。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔RDBMSの主な仕様〕2 (4) および〔参照処理の性能見積り〕に基づいて説明します。
「加盟店」テーブルは、入れ子ループ法における内側の表であり、主キー索引を用いた索引探索によってランダムアクセスされています。〔RDBMSの主な仕様〕2 (4) にある通り、ランダムアクセスは同期データ入出力処理となります。
同期データ入出力処理では、データI/OとCPU処理が並行して行われないため、物理ディスクへのI/O処理時間がそのまま全体の処理時間の増大に直結します。
データバッファを増やしてヒット率を上げる(案1)ことで、この同期データ入出力(ランダムアクセス)の物理的なI/O回数が削減され、処理時間を短縮することができます。
高得点のポイント
- 「加盟店」テーブルへのアクセス経路が ランダムアクセス(または同期アクセス)であることを明記する。
- データバッファの増加がその処理時間の短縮につながるという論理展開を含める。
- 指定された25字以内の文字数制限を守る。
案1について,“オーソリ履歴”テーブルはデータバッファを増やさないのはなぜか。アクセス経路に着目し,理由を25字以内で述べよ。
模範解答
順次アクセスの処理時間に影響しないから
採点基準
- 2点: “オーソリ履歴”は表探索(順次アクセス)であり、データバッファを増やしてもその処理時間は変わらない(短縮されない)ことを述べている(非同期・先読みへの言及は不要)。
- 1点: 処理時間に影響しないとだけ述べ、アクセス経路(表探索や順次アクセス)に触れていない。
- 0点: 上記の内容が含まれていない。
- 1点: データバッファ増加が処理時間短縮に寄与しない理由が論理的に説明されている。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔RDBMSの主な仕様〕2 (5) および〔参照処理の性能見積り〕に基づいて説明します。
「オーソリ履歴」テーブルは表探索による順次アクセスを行っています。表探索では全ページを先頭から1回ずつ読むので、データバッファを増やしてもバッファヒット率は上がらず、順次(非同期)読込みの処理時間は変わりません。
補足として、〔RDBMSの主な仕様〕2 (5) にある通り、順次アクセスは非同期データ入出力処理であり、SQL処理時間は となります。本見積りにおいて、外側表のCPU時間は96,000秒、非同期データ入出力処理時間も96,000秒です。CPU時間(96,000秒)が律速となるため、全体のSQL処理時間は短縮されません。
そのため、バッファを増やす効果(順次アクセスの処理時間への影響)がないと判断できます。
高得点のポイント
- 「オーソリ履歴」テーブルへのアクセス経路が 順次アクセス(または非同期アクセス)であることを明記する。
- 順次アクセスの特性により、データバッファ増加が全体の処理時間に影響しない(短縮に寄与しない)という論理展開を含める。
- 指定された25字以内の文字数制限を守る。
案2を適用した場合,オーソリ処理の処理時間が長くなると考えられる。その理由を25字以内で述べよ。
模範解答
行の挿入時に更新する索引が増えるから
採点基準
- 2点: 副次索引の追加により、行の挿入時に更新すべき索引が増えることを指摘できている。
- 1点: 更新負荷の増加に触れているが、索引が増加することへの言及が不明確。
- 0点: 上記の内容が含まれていない。
- 1点: 副次索引の追加とINSERT処理の性能低下の関係が論理的に説明されている。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔カード決済システムの概要〕2. オーソリ処理(オンライン処理)の内容に基づいて説明します。
オーソリ処理では、審査結果を判定した後に「“オーソリ履歴”テーブルに挿入する」処理(INSERT)が行われます。
案2では、「利用日列をキーとする副次索引を追加」します。リレーショナルデータベースにおいてテーブルに新しい索引を追加すると、テーブルへ行をINSERTする際に、テーブル本体や主キー索引だけでなく、追加した副次索引に対する更新処理も同時に発生します。
そのため、オーソリ処理(INSERT)時に更新すべき索引データが増加し、書き込みのオーバーヘッドによって処理時間が長くなります。
高得点のポイント
- 副次索引の追加によって、行の挿入時(INSERT時)に更新しなければならない 索引が増える ことを明記する。
- 索引の更新負荷の増加が性能低下の原因であるという因果関係を含める。
- 指定された25字以内の文字数制限を守る。
設問1は,特に(1)d~hの正答率が低かった。入れ子ループ法の動きを復習し,外側表の結果行数が内側表の検索回数になること,検索回数は内側表の総ページ数とは無関係に大きくなり得ることを理解してほしい。
設問2
〔“オーソリ履歴”テーブルの区分化〕について,(1)〜(4)に答えよ。
課題1について,案Aと案Bは案Cに比べてオーソリ処理のINSERT文の性能が良いと考えられる。その理由を25字以内で具体的に述べよ。
模範解答
挿入される行が複数の区分に分散するから
採点基準
- 2点: 挿入される行(INSERT 先)が複数の区分に分散することを述べている(競合・集中の回避への言及は不要)。
- 1点: 分散することに触れているが、何が分散するか不明確である。
- 0点: 上記の内容が含まれていない。
- 1点: 区分キーによる行の分散が INSERT 文の性能が良い理由として文意が通っている(「挿入される行が複数の区分に分散するから」の形で満点)。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔“オーソリ履歴”テーブルの区分化〕と表2の内容に基づいて説明します。
課題1は「月末近くに起きるオーソリ処理のINSERT文の性能低下を改善すること」です。
案Cは「利用日」を区分キーとするレンジ区分です。月末などの同日に発生する大量のオーソリ処理(INSERT)は、同じ利用日を持つため、特定の1つの区分(当月分の領域)に集中して物理的な書き込みアクセスが競合します。
一方、案A(ハッシュ)や案B(レンジ)の区分キーは「カード番号」です。同じ日に発生するトランザクションであっても、カード番号はランダムにバラバラであるため、INSERTされる行は複数の区分に分散して格納されます。結果として書き込みの局所化(競合)が防がれ、性能が良くなります。
高得点のポイント
- カード番号による区分化(案A、案B)の特性として、挿入される行が 複数の区分に分散する ことを明記する。
- データの分散がアクセスの集中(競合)を防ぎ、性能向上につながるという因果関係を含める。
- 指定された25字以内の文字数制限を守る。
課題2について,区分限定の表探索を行う場合,1ジョブが探索する区分数の最小値は幾らか。表2中の イ に入れる適切な数値を答えよ。
模範解答
1
解説
【問題の本文・図表】表2「課題ごとに各案を評価した結果」および図3「区分化に対応したSQL文のWHERE句」に基づいて算出します。
案Cは「利用日」を区分キーとし、「1か月を1区分」とするレンジ区分です。
利用明細抽出処理(課題2)のSQL文(図3)では、A.利用日 BETWEEN :hv1 AND :hv2 と指定されており、ホスト変数 hv1, hv2 は「請求対象月の初日と末日」を表します。
つまり、1回のジョブで探索すべき期間は「特定の1か月間」のみとなります。案Cでは1か月が1区分に割り当てられているため、1ジョブが探索する必要がある区分数は、対象となる該当月の 1 区分のみとなります。
課題2について,区分限定の表探索を行う場合,1ジョブが探索するページ数の最小値は幾らか。表2中の ロ に入れる適切な数値を答えよ。
模範解答
40,000,000
解説
【問題の本文・図表】表1「主なテーブルの将来の容量見積り」と表2の条件に基づいて算出します。
表1より、「オーソリ履歴」テーブル全体のページ数は 24億ページ(2,400,000,000 ページ)です。
〔“オーソリ履歴”テーブルの区分化〕の記載より、「いずれの案も 60 区分に行を均等に分配する前提」となっています。したがって、1区分当たりのページ数は以下の通り均等に計算できます。
ページ
ロの欄は、1ジョブが探索する区分数(イの答え=1)に対応する探索ページ数です。
1区分を探索するため、探索するページ数の最小値は 40,000,000 ページとなります。
課題2について,案Aではカード番号にBETWEEN述語を追加しても改善効果を得られないと考えられる。その理由を30字以内で具体的に述べよ。
模範解答
区分方法がハッシュでは探索する区分を限定できないから
採点基準
- 2点: ハッシュ区分では範囲(BETWEEN)検索において探索する区分を限定できないことを理解している。
- 1点: 改善効果が得られない理由に触れているが、ハッシュ区分における範囲検索の特性に関する説明が不十分。
- 0点: 上記の内容が含まれていない。
- 1点: ハッシュ区分の特性と検索範囲の絞り込み不可の関係が論理的に説明されている。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔RDBMSの主な仕様〕1 (3) の区分方法の説明に基づいて説明します。
案Aは「カード番号」を区分キーとした ハッシュ 区分です。
ハッシュ区分は、RDBMSが区分キーの値からハッシュ関数を用いてハッシュ値を生成し、その値によって格納先の区分を決定します。この方式において、SQL文のWHERE句で カード番号 BETWEEN :hv3 AND :hv4 のように範囲(レンジ)条件を指定した場合、指定された範囲内に存在する個々のキー値がどのハッシュ値になるかを一括して特定することはできません。
そのため、RDBMSは探索する区分を特定の区分に限定(プルーニング)できず、結果的にすべての区分を探索しなければならないため、改善効果が得られません。
高得点のポイント
- ハッシュ区分においては、BETWEEN述語のような範囲指定では 探索する区分を限定できない(全区分を探索する必要がある)ことを明記する。
- ハッシュ区分の特性(ハッシュ値による分散)と範囲検索の不適合性についての因果関係を含める。
- 指定された30字以内の文字数制限を守る。
課題3について,特に案Cは,区分キーの特徴から,案Aと案Bに比べて再編成の効率が良いと考えられる。その理由を20字以内で具体的に述べよ。
模範解答
1区分だけを再編成すれば良いから
採点基準
- 2点: 案Cでは再編成の対象が1つの区分(1か月分)だけで済むため効率が良いことを理解している。
- 1点: 再編成の範囲が狭まることには触れているが、1区分に限定されることの説明が不十分。
- 0点: 上記の内容が含まれていない。
- 1点: 再編成の対象が1区分(前月分の区分)に限られることが理由として述べられている(利用日・区分キーへの言及は不要)。
- 0点: 論理的なつながりが不明確である。
解説
【問題の本文・図表】〔RDBMSの主な仕様〕1 (4) および課題3の内容に基づいて説明します。
課題3は「月初に行う“オーソリ履歴”テーブル再編成の処理時間を短縮すること」です。
テーブル再編成は、行を主キー順に並び替えたり空き領域を確保したりする重い処理です。案Cでは、「利用日」をキーとしたレンジ区分を採用し、「1か月を1区分」としています。この設計により、前月分の追加・更新データは、直近の1か月分に該当する特定の「1区分」に集中して格納されています。
したがって、月初のメンテナンス時には、データが散らばっている全区分を処理する必要はなく、更新対象となった 1区分だけを再編成すれば良い ため、案Aや案B(カード番号による全区分への分散)に比べて処理時間が大幅に短縮され、効率が良くなります。
高得点のポイント
- 案Cの設計(1か月を1区分)により、再編成の対象が特定の 1区分だけ に限定されることを明記する。
- 再編成対象の範囲が狭まることが、処理時間短縮・効率化につながるという因果関係を含める。
- 指定された20字以内の文字数制限を守る。
設問2は,全体的に正答率がやや低かった。区分表の設計においては,範囲の限定,負荷分散を目的として,“時間的なキー”(例.利用日)と,“空間的なキー”(例.カード番号)を,組み合わせる技法がよく用いられる。区分表の利点をよく理解し,キーの特徴を利用した設計を行う技術を身に付けてほしい。
設問3
〔更新処理の多重化〕について,(1),(2)に答えよ。
ジョブの多重度を幾ら増やしても,それ以上は更新処理全体の処理時間を短くできない限界がある。このときボトルネックになるのはログである。その理由をRDBMSの仕様に基づいて30字以内で述べよ。
模範解答
コミットはログ出力処理の完了まで待たされるから
ログ出力処理は並列化されないから
ログ出力処理は逐次化されるから
ログバッファが一杯だと更新が待たされるから
採点基準
- 3点: 「コミットはログ出力処理の完了まで待たされる」「ログ出力処理は並列化されない」「ログ出力処理は逐次化される」「ログバッファが一杯だと更新が待たされる」のいずれか一つ(同趣旨の言い換え: ログバッファが一つしかない、ログ出力が直列になる 等を含む)を述べている。
- 2点: ログ出力処理・ログバッファの仕様に触れているが、待たされる・並列化されない・逐次化される のどの要素も読み取れない。
- 1点: 「ログがボトルネックだから」のように設問の言い換えだけにとどまっている。
- 0点: ログに関係しない。
- 3点: 「コミットはログ出力処理の完了まで待たされる」「ログ出力処理は並列化されない」「ログ出力処理は逐次化される」「ログバッファが一杯だと更新が待たされる」のいずれか一つ(同趣旨の言い換え: ログバッファが一つしかない、ログ出力が直列になる 等を含む)が、理由として文意が通る形で述べられている。
- 2点: 因果関係の説明は概ねできているが、論理の飛躍や分かりにくい表現がある。
- 1点: 因果関係の説明が不十分であり、論理的な構成に欠ける。
- 0点: ログに関係しない。
解説
【問題の本文・図表】〔RDBMSの主な仕様〕2 (6) および (7) に基づいて説明します。
ジョブを多重化しても更新処理がスケールしない(限界がある)理由は、RDBMSのログバッファおよびログ出力処理の仕組みにあります。
仕様2 (7) には「トランザクションのコミットはログ出力処理の完了まで待たされる」と記載されています。また、仕様2 (6) にあるように、ログバッファはRDBMS内に「一つ」しか存在しません。複数の更新ジョブが同時にコミットを発行しても、最終的に単一のログバッファからディスクへの物理的なログ出力処理が完了するまで各ジョブは待機しなければなりません。このログ出力処理が直列化(逐次化)のボトルネックとなるため、多重度をいくら上げても全体の処理時間を短くできなくなります。
高得点のポイント
更新処理では1,000行更新するごとにコミットしているが,仮に1行更新するごとにコミットすると,更新処理の処理時間のうち何がどのように変わるか。本文中の用語を用いて25字以内で述べよ。
模範解答
ログ出力処理の待ち時間の合計が長くなる。
コミット時の待ち時間の合計が長くなる。
採点基準
- 3点: 「ログ出力処理の待ち時間」又は「コミット時の待ち時間」(何が)の合計が長くなる(どのように)を述べている(公式2例はどちらも満点。コミット回数への言及は不要)。
- 2点: 待ち時間が長くなることは述べているが、何の待ち時間か不明確である。
- 1点: 「処理時間が長くなる」とだけ述べている。
- 0点: 無関係な内容。
- 3点: 「何が」「どのように」の両方が明確に読み取れる。
- 2点: 「何が」「どのように」のどちらかがあいまいである。
- 1点: 「何が」「どのように」のどちらかが欠けている。
- 0点: 無関係な内容。
設問3は,(2)の正答率が低かった。トランザクションのコミット時には,ログバッファにあるログの量を問わず,ログがディスクに出力される。このとき,トランザクションのコミットは,ログ出力処理の完了まで待たされるので,過度にコミットを行うと,ログ出力処理の待ち時間が長くなる。バッチ処理では適度なコミットインターバルを設定することが重要であることを是非知っておいてもらいたい。